01 STORY FIRST
先写一个,
让人想看下去的故事。
真正拉开差距的不是提示词,而是剧情有没有意思。先和豆包或 GPT 好好沟通:你想讲什么,观众会在哪一刻笑,又会在哪一刻被打动。
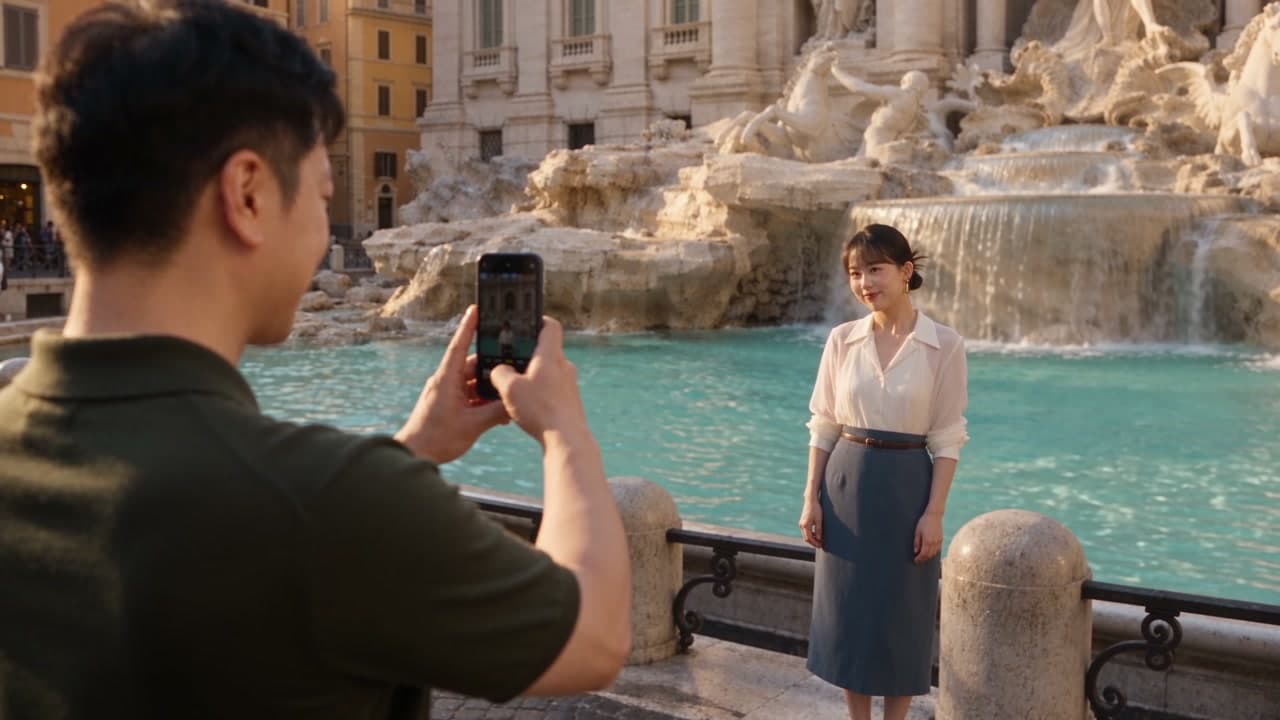
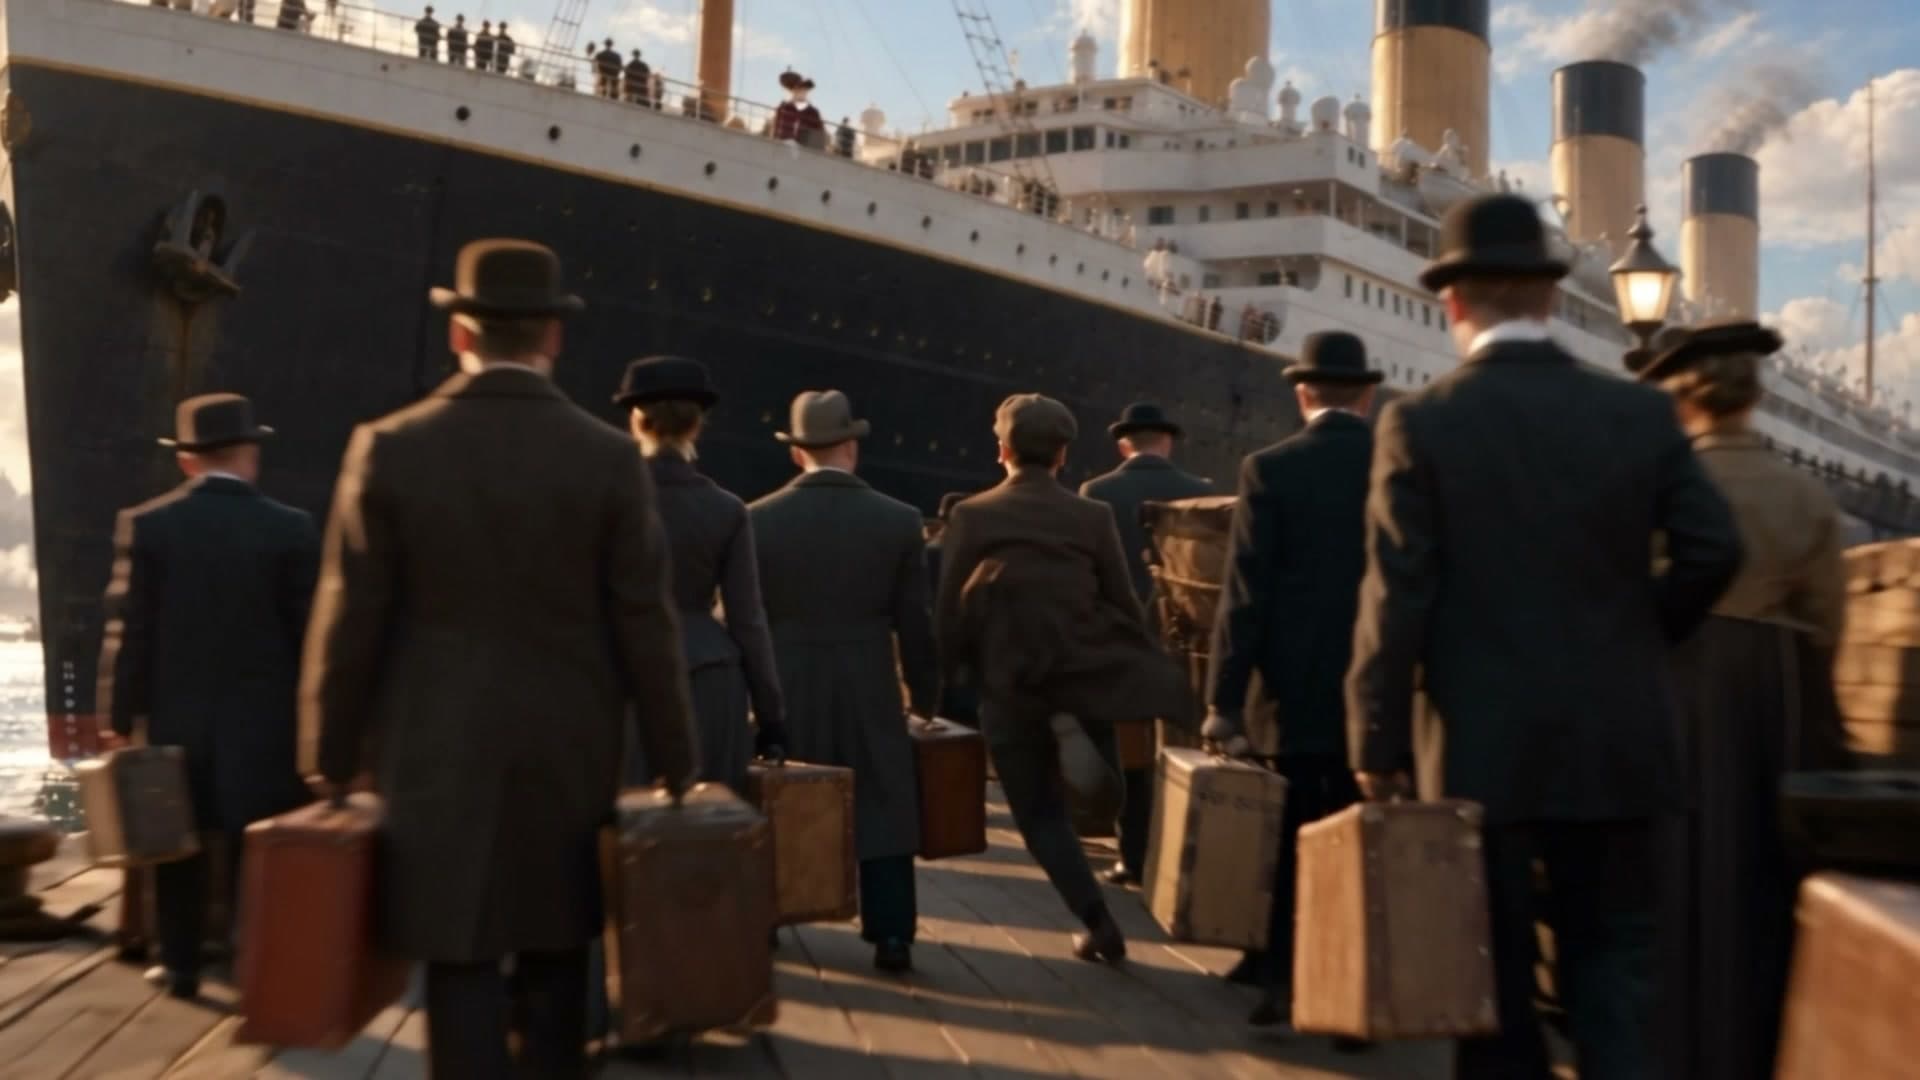
我的选择是「熟悉的电影 + 我们自己的经历」。经典场景让人会心一笑,罗马蜜月和婚礼现场,让它不再是一支谁都能用的 AI 短片。
我的做法
先想好结尾怎样接上真实入场,再往前安排这场冒险。
THE IDEA
婚礼入场前,我想给大家放一支不一样的短片。不是照片轮播,而是让我们真的走进那些熟悉的电影场景:登上泰坦尼克号,拿起光剑,再回到属于自己的故事。
AI 让这件事变得可能。但最有意思的,不是生成了多逼真的画面,而是影片结束时,故事刚好接上了现实。
Keaton 创作 / 剧情 / AI 制作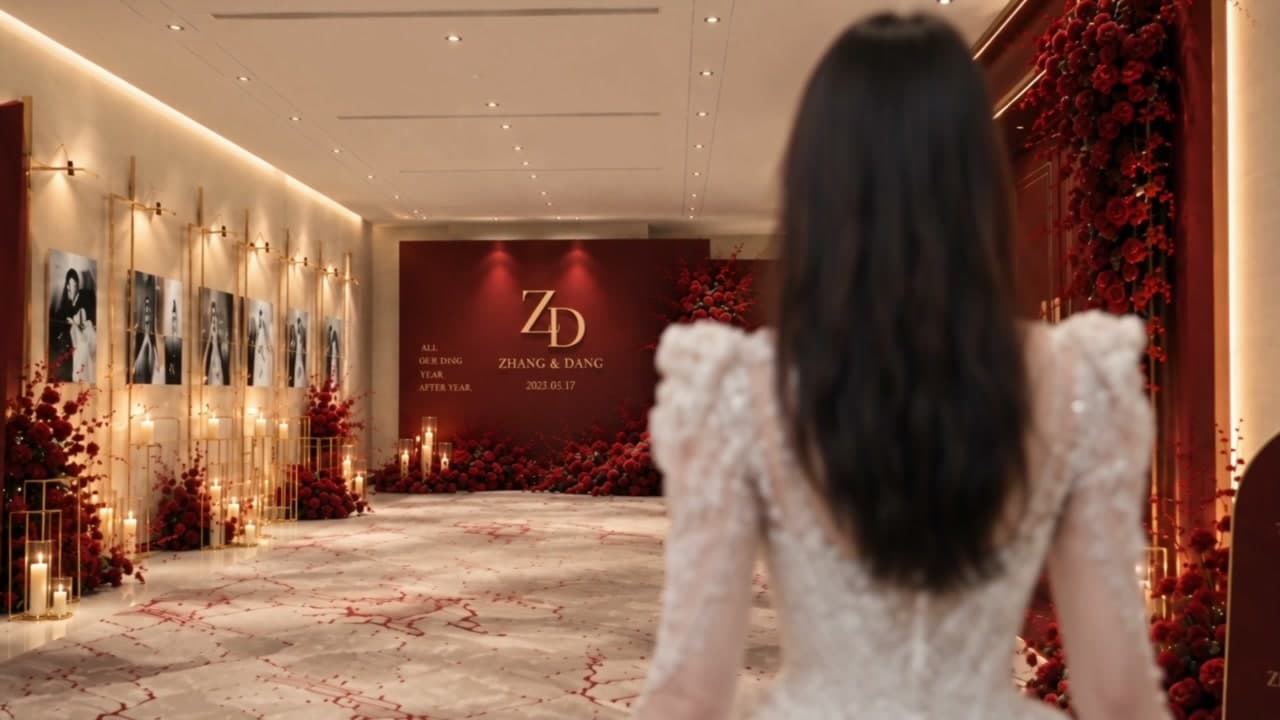 最后一幕 / 回到现实
THE BEST TRANSITION
我把婚礼场地也放进了短片。片中的我们,从不同方向走向会场,推开门;现实中,我们接着走进婚礼现场。
不是为了炫技。是为了这一刻。
BEHIND THE SCENES
制作手记 / 02不需要先变成提示词专家。
把想法拆成三步,一步一步做成画面。
真正拉开差距的不是提示词,而是剧情有没有意思。先和豆包或 GPT 好好沟通:你想讲什么,观众会在哪一刻笑,又会在哪一刻被打动。
我的选择是「熟悉的电影 + 我们自己的经历」。经典场景让人会心一笑,罗马蜜月和婚礼现场,让它不再是一支谁都能用的 AI 短片。
先想好结尾怎样接上真实入场,再往前安排这场冒险。
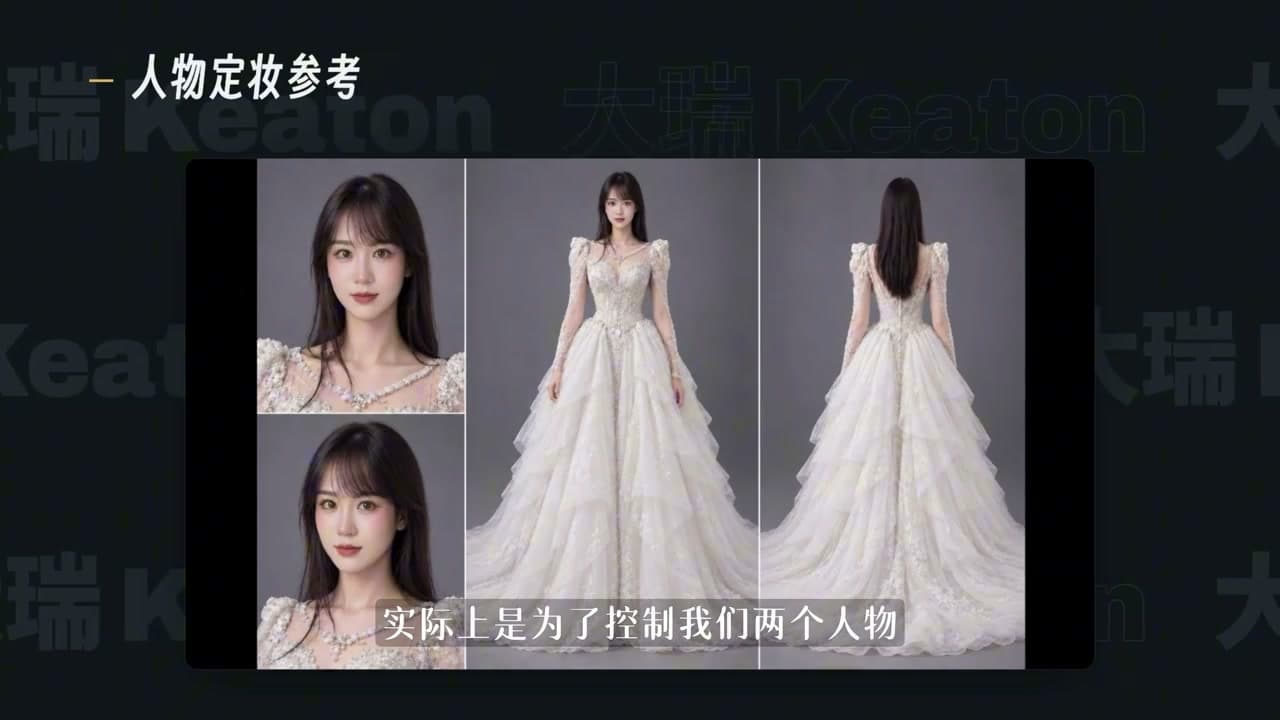
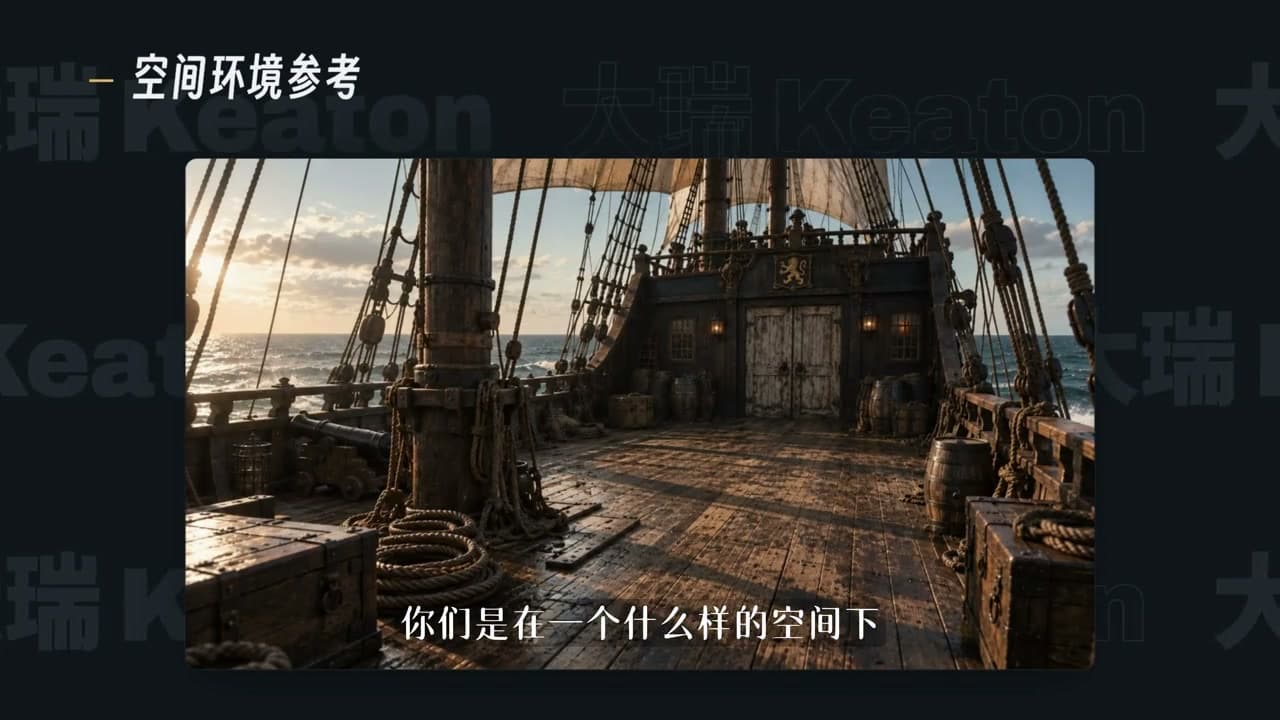
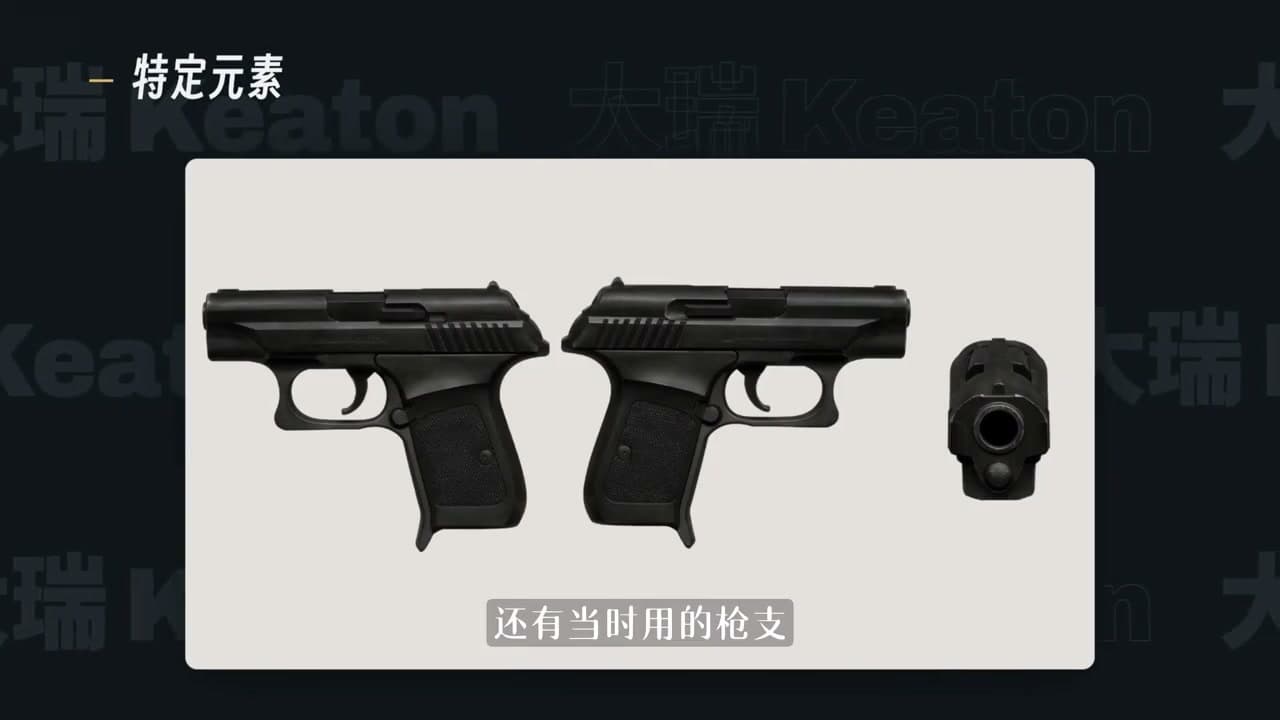
剧情确定后,为每一幕准备人物定妆照、场景图和必要的道具图。人物参考负责「还是同一个人」,场景参考负责「还是同一个空间」。
手枪、马匹这类特殊元素,可以单独生成参考。每段视频只放需要用到的图片,不相关的不要塞进去。
一张整体空间图 + 必要的人物参考,通常比一堆空间关系互相矛盾的关键帧更有效。把连续动作留给视频模型理解。
我把提示词分成三部分。先说这一段演什么、需要多久;再解释参考图;最后按秒写清镜头里的动作和衔接。
不用从零手写。把剧情、已有的参考图和这个结构交给豆包或 GPT,让它帮你整理,再由你检查有没有讲错。
发生什么 · 风格 · 总时长
用哪张图 · 具体参考什么
人物动作 · 镜头运动 · 前后衔接
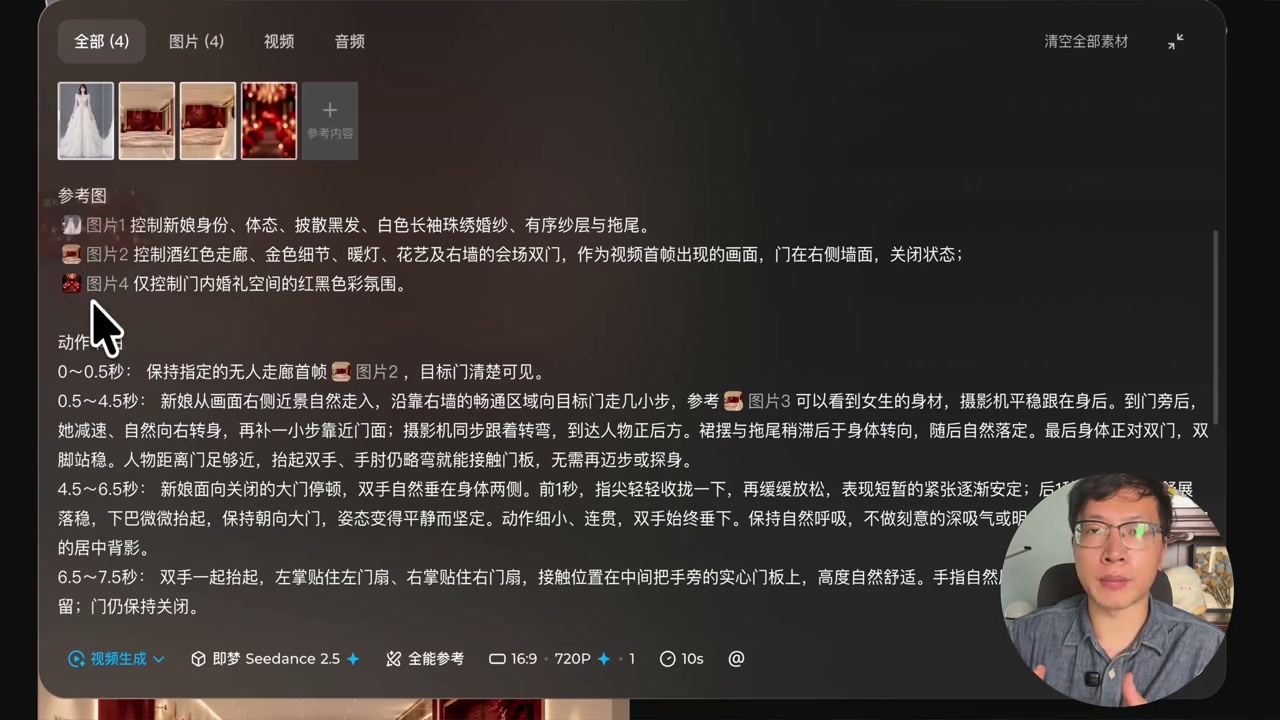
请根据我提供的剧情和参考图,整理一段 AI 视频生成提示词,分为三个部分:

1. 画面总览
说明这段视频发生了什么、整体风格和总时长。根据动作复杂度分配时间,不要为了压缩秒数而省略关键动作。

2. 参考图
只使用本段需要的图片,逐张说明参考目标:人物外貌与服装、场景空间关系、或特定道具。无关图片不要加入。

3. 详细分镜
按时间段描述人物动作、镜头运动、空间关系和前后衔接。重点写清关键动作如何发生,以及最后如何收束。

本段剧情:[填写你的剧情]
总时长:[填写秒数]
已有参考图:[附图,并说明每张图的用途]
NOTES FROM THE PROCESS
生成一次就是一次成本。
这几件事,比反复碰运气更值得做。
这次主要用 Seedance 2.5,在即梦和 Higgsfield 上制作。我的实际感受是效果接近,可以比较套餐价格再选。
按我制作时的开销,720P 大约每秒 1 元,1080P 更贵。婚礼大屏会放大模糊感,元素复杂的镜头,我更愿意用 1080P。
个人制作时的成本参考,非平台现行报价。我会先用相对便宜、效果能接受的模型(例如 Seedance 2.0)试一版,发现提示词中明显的问题。修改后,再交给正式模型。
时间太短,模型可能砍掉细节;时间太长,又可能脑补多余动作。按镜头真正需要的时间分配,反而比来回重生成更省。
最后,把片段剪在一起,配上你想要的音乐。
工具完成画面,你完成故事。
THE FULL WALKTHROUGH
从最开始的想法,到生成中的取舍。
完整的制作分享,都在这支视频里。