2026 年,我依然视我的上下文如黄金
模型已经有上百万 Token 的上下文,为什么还是会跑偏、抓不住重点?因为装得下不等于用得好。Agent Harness 很大一部分工作其实就是上下文管理,而剩下的那部分,只能你自己做。
为什么现在的模型已经有上百万 Token 的上下文,还是会跑偏、抓不住重点?
首先模型上下文确实越来越高了,但我的建议反而是:
无论模型能接受多少上下文,能少给 AI 的东西,就别多给。
因为装得下,不等于用得好。你可以把上下文理解成开会时摆在桌上的材料。桌上只有开会的核心议题和文件,大家很快就能进入正题。如果把公司十年的档案全搬进会议室,资料确实多了,但这个会大概率开不好。
AI 也是一样。你把项目文件、聊天记录和执行日志一股脑塞给它,它就更容易漏掉真正重要的信息。
这不是猜测。Anthropic 在官方文章里也提到:上下文变长以后,模型准确找到并使用其中信息的能力通常会下降。他们把这种现象叫「Context Rot 上下文腐化」。到了 Agent 时代,真正稀缺的已经不是上下文窗口,而是高质量的上下文。
前段时间为了研究 Agent,自己从头写了一个。拆完里面各种 Harness 的实现以后,我发现一个很有意思的事情:
Agent Harness 很大一部分工作,其实就是上下文管理。
不断决定:什么东西现在应该上桌,什么东西应该下桌。
比如 Skill,Agent 不会把所有 Skill 的完整内容永远塞在上下文里,而是先知道自己有哪些能力,真正需要的时候再加载对应 Skill。
再比如子 Agent,是另开一张工作台。让它在独立的上下文里搜索几百个网页、做事情,最后汇报给主 Agent,主 Agent 只需要知道结论,多的你不要给我讲。
细看很多设计都是同一个逻辑,都是在解决:怎么样让模型保持最核心有用的上下文。
那既然 Agent 自己会管理上下文,我们还需要管理吗?一定需要。因为只有你最了解你的任务需要什么信息,Agent 不可能完全替你做好上下文管理,因为它不知道哪些信息对你来说才是真正不能丢的。 平台可以帮你压缩、检索、裁剪,但这些操作本身都有信息损失的风险。我们自己也得主动管理这张桌子。
给你几个马上能用的习惯。
第一,一个对话只处理一个主题。 任务已经变了,就开新对话。不要因为舍不得前面的聊天记录,把完全不同的事情硬塞在一起。
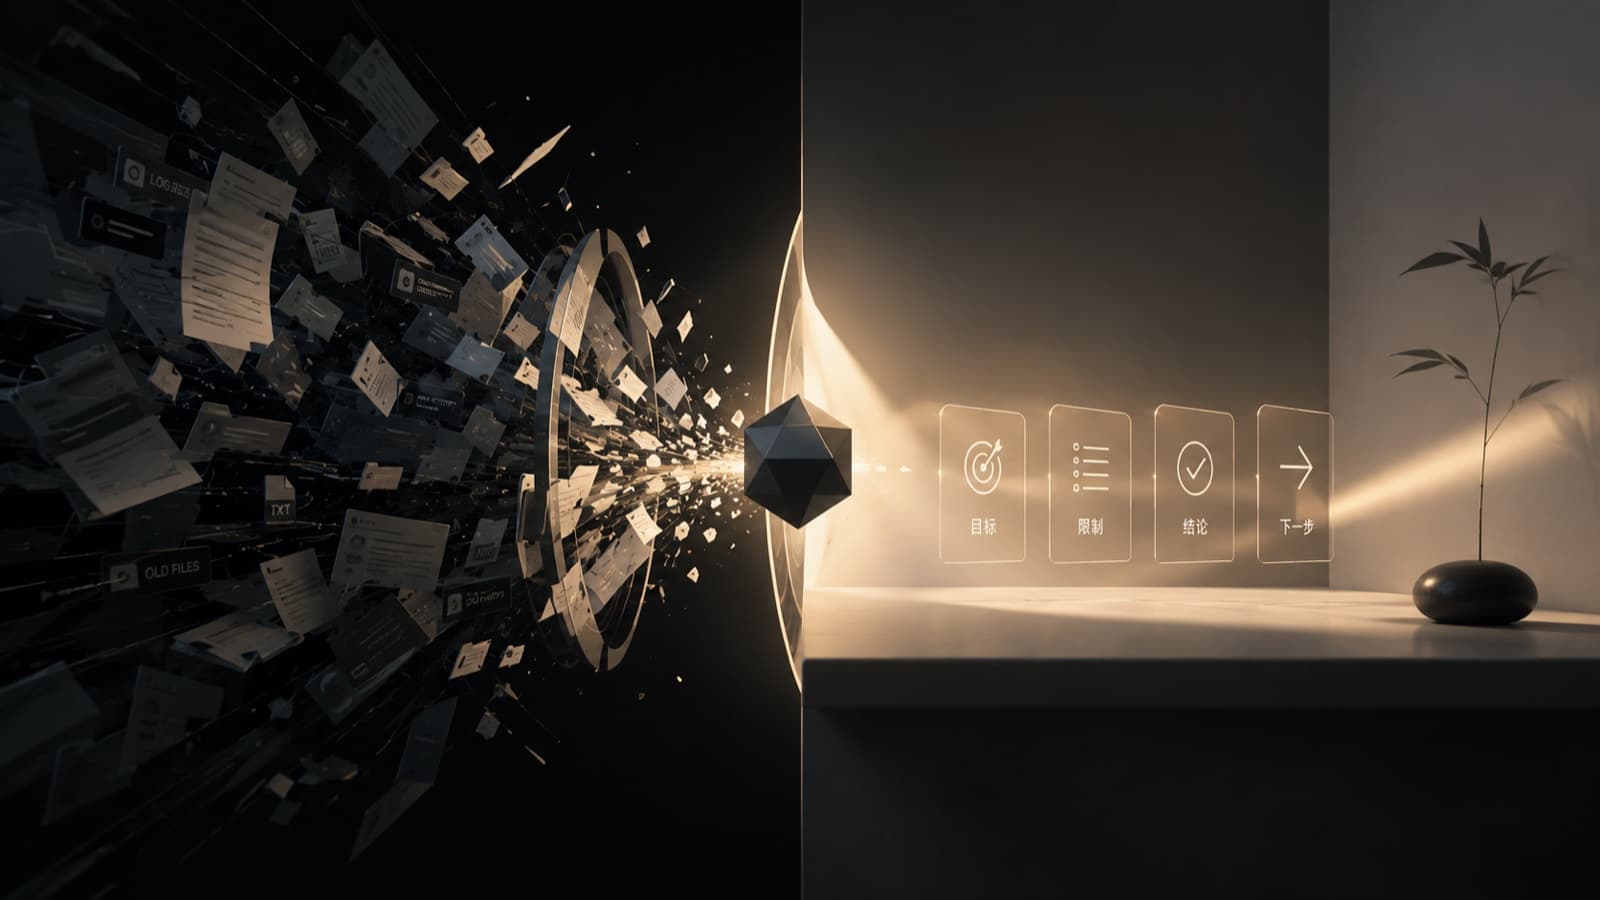
第二,如果真的是有前后依赖的长任务,每完成一个阶段,就让 AI 做一次压缩总结。 运行一次 compact;如果任务已经变了,直接 /clear 清空上下文。真正值得带到下一阶段的,通常只有四样:任务目标、重要限制、已经确认的结论、接下来做什么。
第三,把资料搜集和独立评审交给子智能体。 如果是一个比较复杂的任务,先明确让你的 Agent 拆解任务,判断哪些可以用子 Agent。比如调研只是其中的一环,那一定要用 Subagent,不把这些资料塞到上下文里,很容易影响任务后面和调研没关系的环节;另外评审这种工作也要用 Subagent,因为模型自己给自己做的东西打分一般会打得很高,子 Agent 是清空上下文运行的,直接失忆,看不到你之前的设计思路。一句话总结就是 主 Agent 做判断,Subagent 做脏活。
第四,大量资料按需加载,不要让 Agent 一次性读所有文件。 我发现这是很多人会犯的问题,一次性让它把你所有文件都读了,如果你项目空间很大,后面每个问题的幻觉率都会变高。更好的方式是让它先理解你项目空间的目录结构,再根据问题判断需要读哪些文件。
真正会用 AI 的人,不是最会往里塞东西的人,而是最清楚什么不该进来的人。